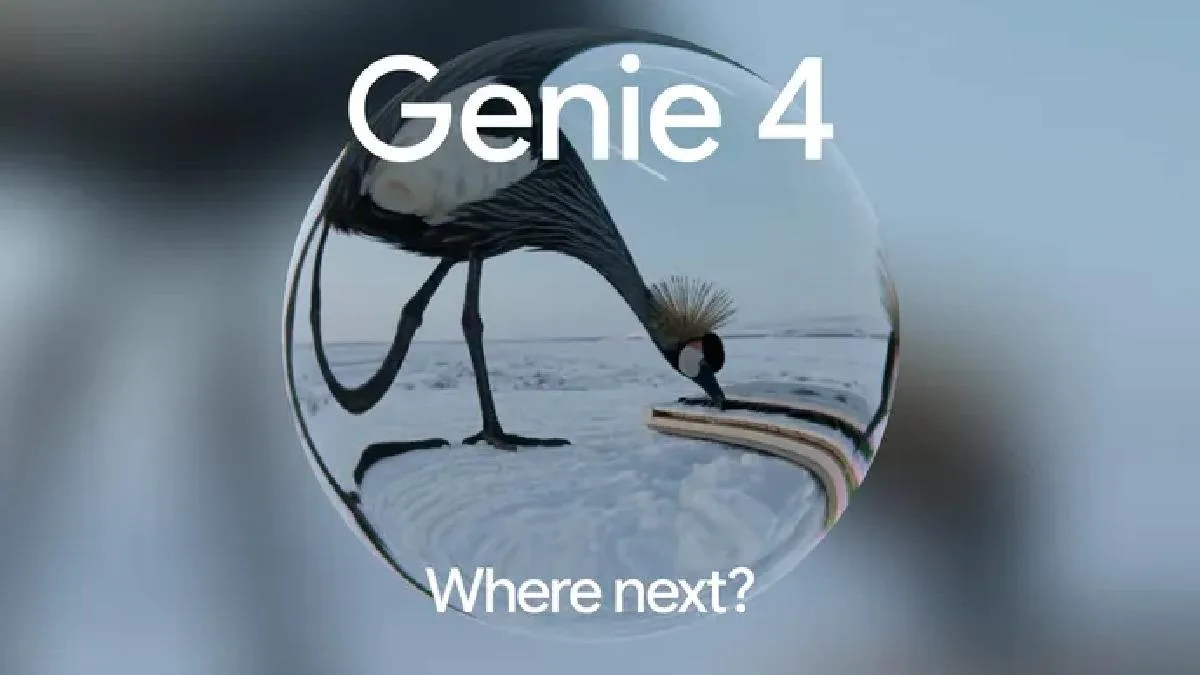

Google DeepMind franchit une nouvelle étape dans la création d'univers virtuels en temps réel par intelligence artificielle. Le modèle Genie 4, tout juste annoncé, génère des simulations fotoréalistes que l'utilisateur peut diriger au clavier ou en langage naturel. Il est pour l'instant proposé en avant-première recherche uniquement.
S'appuyant sur les bases de Genie 3, présenté il y a environ un an, le modèle promet un niveau de réalisme et d'interactivité inédit. Les contenus d'exemple partagés par l'entreprise soutiennent cette ambition.
Intervenir pendant que la simulation tourne
Ce qui distingue Genie 4 de ses prédécesseurs et des outils concurrents, c'est la possibilité de modifier l'environnement sans interrompre la simulation. L'utilisateur peut déclencher la pluie, changer le point de vue de la caméra ou faire apparaître de nouvelles personnes et de nouveaux objets dans la scène.
Tout cela se fait sans scènes 3D préconstruites ni interactions codées à la main : les images sont générées image par image, en temps réel, au fur et à mesure que l'utilisateur se déplace dans le monde. Les sons d'ambiance, y compris le vent et les voix humaines, sont eux aussi produits en direct.
Deux minutes de cohérence et une meilleure physique
Le modèle conserve sa cohérence jusqu'à deux minutes dans une même scène, soit exactement le double de la limite de Genie 3. Pour Genie 3, Google avait communiqué une résolution de 720p et une cadence de 24 i/s ; pour Genie 4, aucune résolution officielle n'a été annoncée, mais les premières vidéos de démonstration ont été diffusées en Full HD à 24 images par seconde.
Au-delà de la qualité visuelle, la physique progresse nettement : selon DeepMind, les interactions comme les collisions ou l'aérodynamique sont simulées de façon sensiblement plus réaliste que par la génération précédente. Les personnages humains ajoutés à la scène affichent des mouvements plus crédibles et réagissent naturellement aux changements d'environnement comme aux commandes de l'utilisateur.
Des personnages qui parlent, orchestrés par Gemini
Côté sensoriel, l'intégration sonore native est un point fort : Genie 4 génère en synchronisation avec le monde des vagues, du vent, des bruits d'ambiance et de la musique. Les personnages virtuels peuvent en outre tenir des dialogues interactifs en temps réel, en fonction des entrées de l'utilisateur et de ce qui se passe dans le monde — ils cessent d'être des marionnettes pour devenir de véritables acteurs.
C'est l'architecture cognitive de la simulation qui est assurée par les modèles Gemini. Dans le fonctionnement décrit par Google, Gemini agit comme un réalisateur : il décompose les tâches en étapes, supervise en continu les images générées et préserve la cohérence logique de la scène. Dans un exemple technique partagé, Gemini 3.8 Flash jouait le rôle d'un agent superviseur observant la simulation en permanence. Dans une autre expérience, Gemini 4 Argon décomposait des tâches complexes en étapes pour piloter Genie 4 en temps réel. Lors d'un test combinant les deux modèles, une scène où le robot humanoïde Apollo d'Apptronik jouait aux dames a été simulée avec succès.
Limites et conditions d'accès
L'équipe de DeepMind reconnaît sans détour que le modèle est encore à un stade précoce et imparfait : sur les simulations longues, des objets peuvent glisser ou se dégrader, et une accumulation de commandes complexes trop rapide peut casser la continuité.
Qui pourra l'utiliser, et quand ? Genie 4 est pour l'instant réservé aux « testeurs de confiance » désignés par Google. Dans les semaines à venir, les abonnés Google AI Ultra — dont l'abonnement de démarrage mensuel coûte 100 dollars — y accéderont via l'interface Project Genie, qui permet de créer des mondes interactifs à partir de texte et d'images.
Commentaires (0)
Aucun commentaire pour le moment. Soyez le premier !